🎁 Guide et résumé
💌 Abonnez-vous à la newsletter
▬▬▬▬▬▬▬▬▬▬
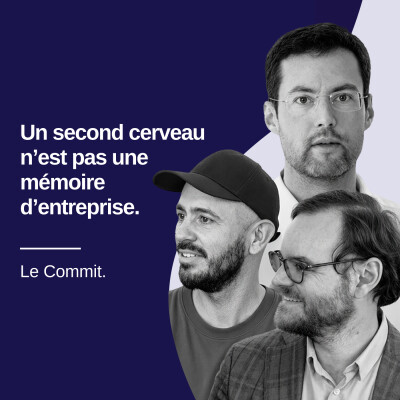
Paul Chevalier, Swann Le Vigouroux et Nicolas Malburet comparent leurs seconds cerveaux et cherchent comment en faire une mémoire d’entreprise.
Enregistrée au Commit, la conférence tech qu’exFabrica organise à Aix-en-Provence, cette table ronde part d’un désaccord : Paul et Nicolas gardent le résultat et laissent filer la donnée brute, Swann garde jusqu’au fichier source pour le réanalyser. Passer à l’échelle de l’entreprise impose ensuite d’empêcher la copie de la mémoire en 5 secondes, de respecter les habilitations et de lui trouver une place à côté des outils qui stockent déjà l’information.
Ce que vous allez apprendre :
- Ce qu’il faut garder : le savoir raffiné ou jusqu’au fichier brut
- Comment ranger une mémoire pour que l’IA ne charge que l’utile
- Pourquoi un dossier de markdown ne fait pas une mémoire d’entreprise
- Comment gérer les habilitations, y compris quand la mémoire en sait plus que vous
- À quoi sert un cerveau d’entreprise face aux outils existants
- Pourquoi désactiver la mémoire automatique de votre assistant IA
🎬 Ressources mentionnées
- LLM Wiki, l’« idea file » d’Andrej Karpathy : https://gist.github.com/karpathy/442a6bf555914893e9891c11519de94f
- Obsidian : https://obsidian.md
Pour contacter les invités :
- Paul Chevalier, Partner CTO chez Socratiz : https://www.linkedin.com/in/paulchevalier-59921630
- Swann Le Vigouroux, Agentic Engineer freelance et ancien CTO : https://www.linkedin.com/in/swannlv et https://swannlv.github.io
- Nicolas Malburet, ingénieur logiciel chez exFabrica : https://www.linkedin.com/in/nicolasmalburet
Disponible en vidéo sur Youtube
Disponible en audio
▬▬▬▬▬▬▬▬▬▬
Postproduction Audio : Guillaume Lefebvre (https://studioecho.webflow.io/)
Music by MADiRFAN from Pixabay
Hébergé par Ausha. Visitez ausha.co/politique-de-confidentialite pour plus d'informations.


🎁 Guide et résumé
💌 Abonnez-vous à la newsletter
▬▬▬▬▬▬▬▬▬▬
Paul Chevalier, Swann Le Vigouroux et Nicolas Malburet comparent leurs seconds cerveaux et cherchent comment en faire une mémoire d’entreprise.
Enregistrée au Commit, la conférence tech qu’exFabrica organise à Aix-en-Provence, cette table ronde part d’un désaccord : Paul et Nicolas gardent le résultat et laissent filer la donnée brute, Swann garde jusqu’au fichier source pour le réanalyser. Passer à l’échelle de l’entreprise impose ensuite d’empêcher la copie de la mémoire en 5 secondes, de respecter les habilitations et de lui trouver une place à côté des outils qui stockent déjà l’information.
Ce que vous allez apprendre :
- Ce qu’il faut garder : le savoir raffiné ou jusqu’au fichier brut
- Comment ranger une mémoire pour que l’IA ne charge que l’utile
- Pourquoi un dossier de markdown ne fait pas une mémoire d’entreprise
- Comment gérer les habilitations, y compris quand la mémoire en sait plus que vous
- À quoi sert un cerveau d’entreprise face aux outils existants
- Pourquoi désactiver la mémoire automatique de votre assistant IA
🎬 Ressources mentionnées
- LLM Wiki, l’« idea file » d’Andrej Karpathy : https://gist.github.com/karpathy/442a6bf555914893e9891c11519de94f
- Obsidian : https://obsidian.md
Pour contacter les invités :
- Paul Chevalier, Partner CTO chez Socratiz : https://www.linkedin.com/in/paulchevalier-59921630
- Swann Le Vigouroux, Agentic Engineer freelance et ancien CTO : https://www.linkedin.com/in/swannlv et https://swannlv.github.io
- Nicolas Malburet, ingénieur logiciel chez exFabrica : https://www.linkedin.com/in/nicolasmalburet
Disponible en vidéo sur Youtube
Disponible en audio
▬▬▬▬▬▬▬▬▬▬
Postproduction Audio : Guillaume Lefebvre (https://studioecho.webflow.io/)
Music by MADiRFAN from Pixabay
Hébergé par Ausha. Visitez ausha.co/politique-de-confidentialite pour plus d'informations.